TP5
Cluster Proxmox VE avec stockage distribué Ceph
4VRT-TP5-CEPH.pdfAvant de commencerContexte et objectifs
| Nœud | Gestion (ens18) | Ceph (ens19) | Rôle |
|---|---|---|---|
proxmox-1 | 192.168.1.11 | 10.10.10.11 | Cluster + MON/MGR/OSD |
proxmox-2 | 192.168.1.12 | 10.10.10.12 | Cluster + MON/MGR/OSD |
| VM de test | 192.168.1.20 | – | Disque sur le pool Ceph |
Les IP .11, .12 et .20 doivent être libres : éteins la VM Ubuntu du TP1 (.20) et, s'ils tournent encore, les nœuds Hyper-V du TP6 (.11, .12). Vérifie aussi qu'il te reste assez de RAM sur le Proxmox de l'école : 2 × 12 Go.
Partie 1Déployer les deux nœuds
Crée deux VM proxmox-1 et proxmox-2 exactement comme au TP2 partie 1 (CPU host, 4 cœurs, disques 20 + 50 Go, Ballooning décoché, Firewall décoché), avec ces différences :
- Memory
12288MiB- 2e carte réseau
- après la création, sur chaque VM : Hardware › Add › Network Device › Bridge
vmbr11, Model VirtIO, Firewall décoché
ISO_PVE="local:iso/proxmox-ve_9.0-1.iso"   # ← adapte au nom réel
for i in 1 2; do
  qm create 15$i --name proxmox-$i --ostype l26 \
    --cpu host --cores 4 --memory 12288 --balloon 0 \
    --scsihw virtio-scsi-single --scsi0 vmdata:20,iothread=1 --scsi1 vmdata:50,iothread=1 \
    --net0 virtio,bridge=vmbr11,firewall=0 --net1 virtio,bridge=vmbr11,firewall=0 \
    --ide2 $ISO_PVE,media=cdrom --boot order='ide2;scsi0'
done
qm start 151; qm start 152
Installe Proxmox sur chacune en suivant le TP2 partie 2 (disque 20 Go, décocher le redémarrage automatique, retirer l'ISO avant de redémarrer), avec :
| VM | Management interface | Hostname (FQDN) | IP (CIDR) |
|---|---|---|---|
| proxmox-1 | la 1re carte (ens18) | proxmox-1.local | 192.168.1.11/24 |
| proxmox-2 | la 1re carte (ens18) | proxmox-2.local | 192.168.1.12/24 |
Puis, sur chaque nœud, passe les dépôts en No-Subscription comme au TP2 (Updates › Repositories). Enfin, chaque nœud doit connaître le nom de l'autre (l'installateur a déjà écrit sa propre ligne dans /etc/hosts) :
echo "192.168.1.12 proxmox-2.local proxmox-2" >> /etc/hosts
apt update && apt full-upgrade -y
ping -c 3 proxmox-2
echo "192.168.1.11 proxmox-1.local proxmox-1" >> /etc/hosts
apt update && apt full-upgrade -y
ping -c 3 proxmox-1
ip -br link      # repère le nom des deux cartes (ens18, ens19)
Vérifie que https://192.168.1.11:8006 et https://192.168.1.12:8006 répondent tous les deux.
Partie 2Créer le cluster
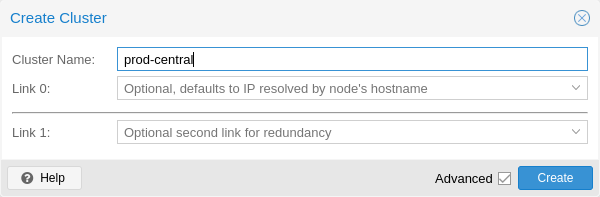
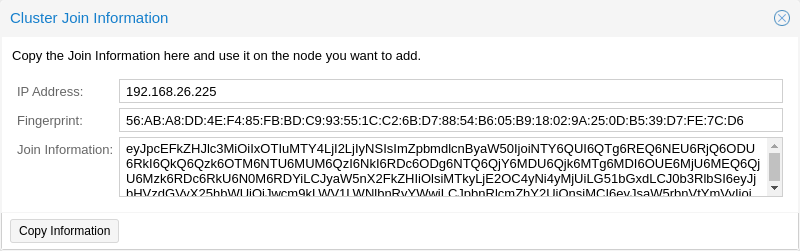
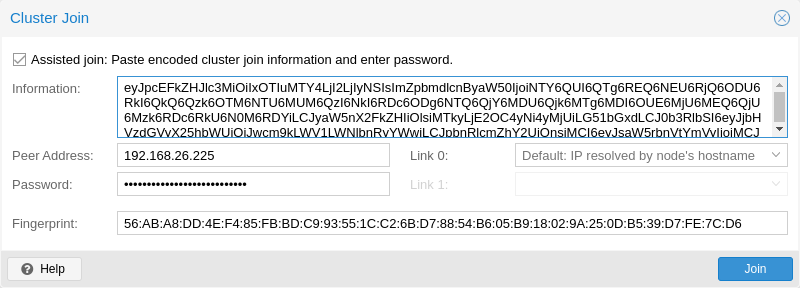
Créer puis rejoindre le cluster Exemple tiré de la Documentation Proxmox VE · clique pour agrandir
# sur proxmox-1
pvecm create CLUSTER-ETU01 --link0 192.168.1.11
# sur proxmox-2
pvecm add 192.168.1.11 --link0 192.168.1.12
# vérifications (sur l'un ou l'autre)
pvecm status
pvecm nodes
corosync-cfgtool -s
Après le « Join », l'interface de proxmox-2 perd la connexion (son certificat change) : recharge la page. Tu peux ensuite administrer les deux nœuds depuis https://192.168.1.11:8006.
Attendu : Quorate: Yes, Expected votes: 2, Total votes: 2.
Partie 3Réseau dédié à Ceph
Flux corosync (cluster) et gestion sur ens18 ; flux Ceph (réplication des OSD) sur ens19, dans un sous-réseau séparé. Les deux cartes passent par le même bridge du Proxmox physique : c'est une isolation logique (sous-réseau distinct), que le sujet autorise.
Même chose sur proxmox-2 avec 10.10.10.12/24. Ne mets pas de passerelle sur ens19.
X=11
grep -n ens19 /etc/network/interfaces      # l'installateur a écrit « iface ens19 inet manual »
sed -i "s|^iface ens19 inet manual|auto ens19\niface ens19 inet static\n        address 10.10.10.$X/24|" /etc/network/interfaces
grep -A2 'iface ens19' /etc/network/interfaces
ifreload -a
ip -br a show ens19
ping -c 3 10.10.10.12
Partie 4Installer Ceph (MON, MGR, OSD)
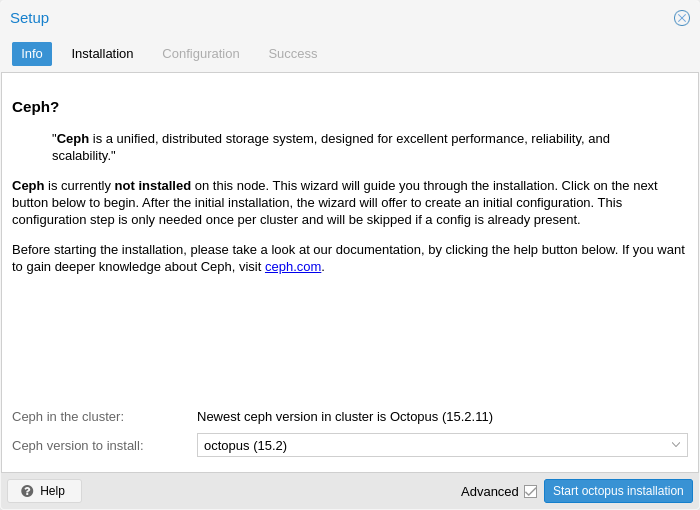
Installer Ceph sur proxmox-1 (assistant)
- Info : version proposée par défaut, Repository No-Subscription › Start … installation.
- Installation : un terminal s'ouvre. Si une question
[Y/n]apparaît, tapeYpuis Entrée. Attends « installed ceph … successfully » › Next. - Configuration : remplis comme ci-dessous, puis Next › Finish.
- Public Network IP/CIDR
192.168.1.0/24- Cluster Network IP/CIDR
10.10.10.0/24- Number of replicas
2(case « Advanced » en bas pour afficher ces champs)- Minimum replicas
1- First Ceph monitor
proxmox-1(l'assistant crée aussi le premier Manager)
Assistant d'installation de Ceph Exemple tiré de la Documentation Proxmox VE · clique pour agrandir
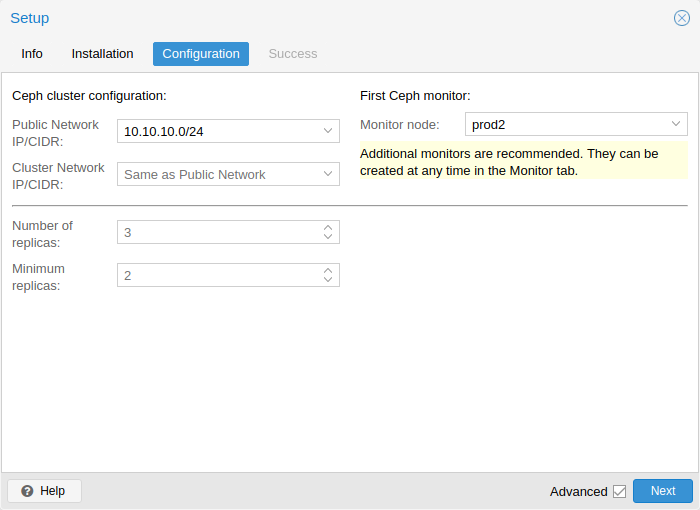
Installer Ceph sur proxmox-2
proxmox-2 › Ceph › Install Ceph : mêmes étapes Info et Installation. À l'étape Configuration, l'assistant indique que la configuration existe déjà (elle est partagée par le cluster) : Next › Finish.
Moniteur et manager sur proxmox-2
Un OSD par nœud
Puis sélectionne proxmox-2 dans l'arborescence et refais Ceph › OSD › Create: OSD › /dev/sdb.
Monitors et OSD dans l'interface Exemple tiré de la Documentation Proxmox VE · clique pour agrandir
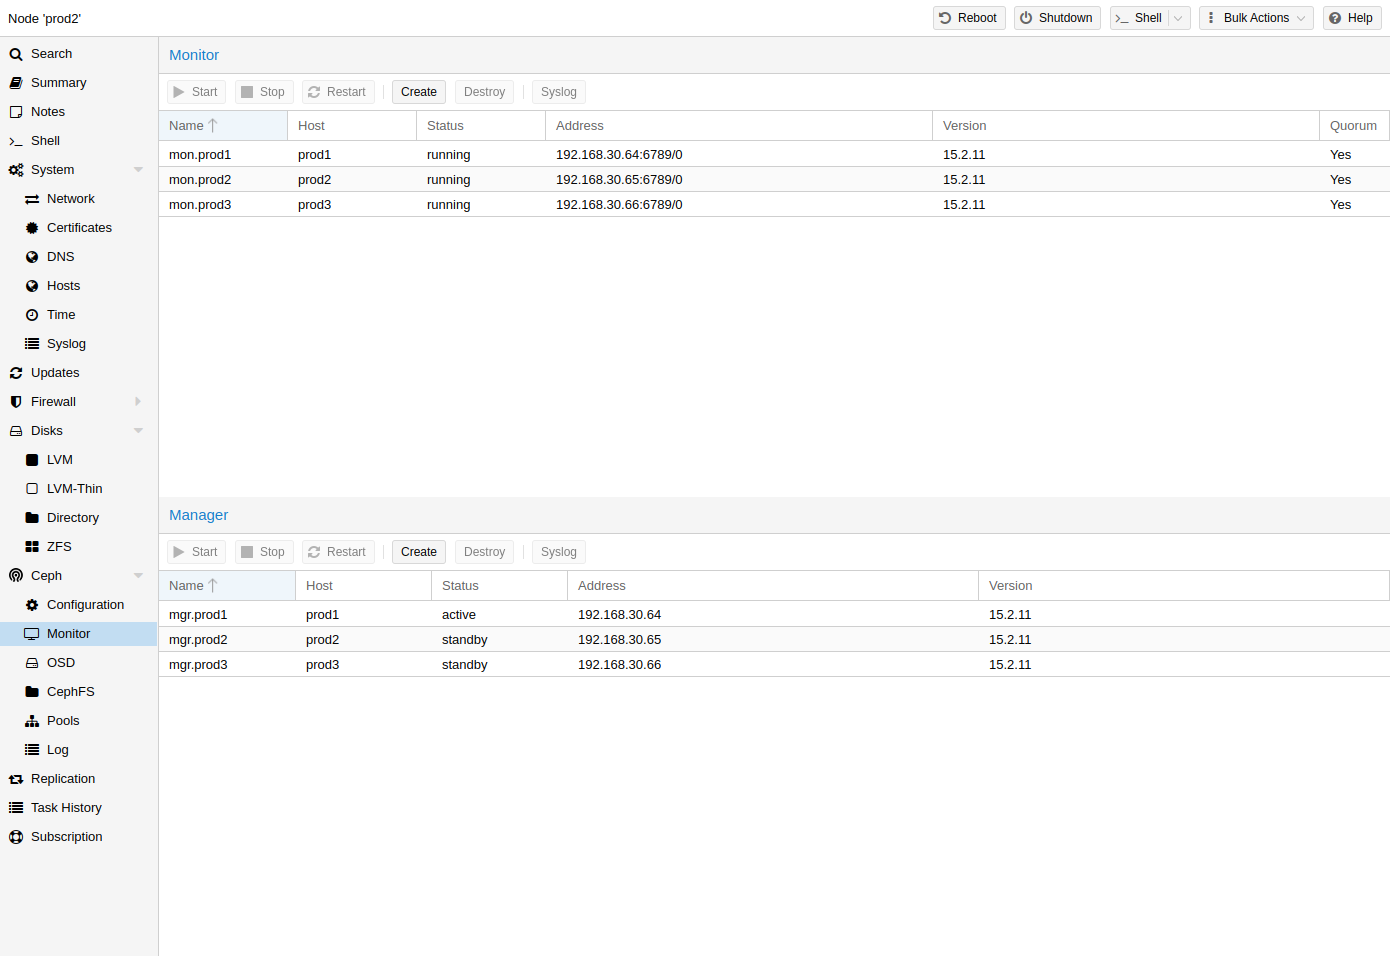
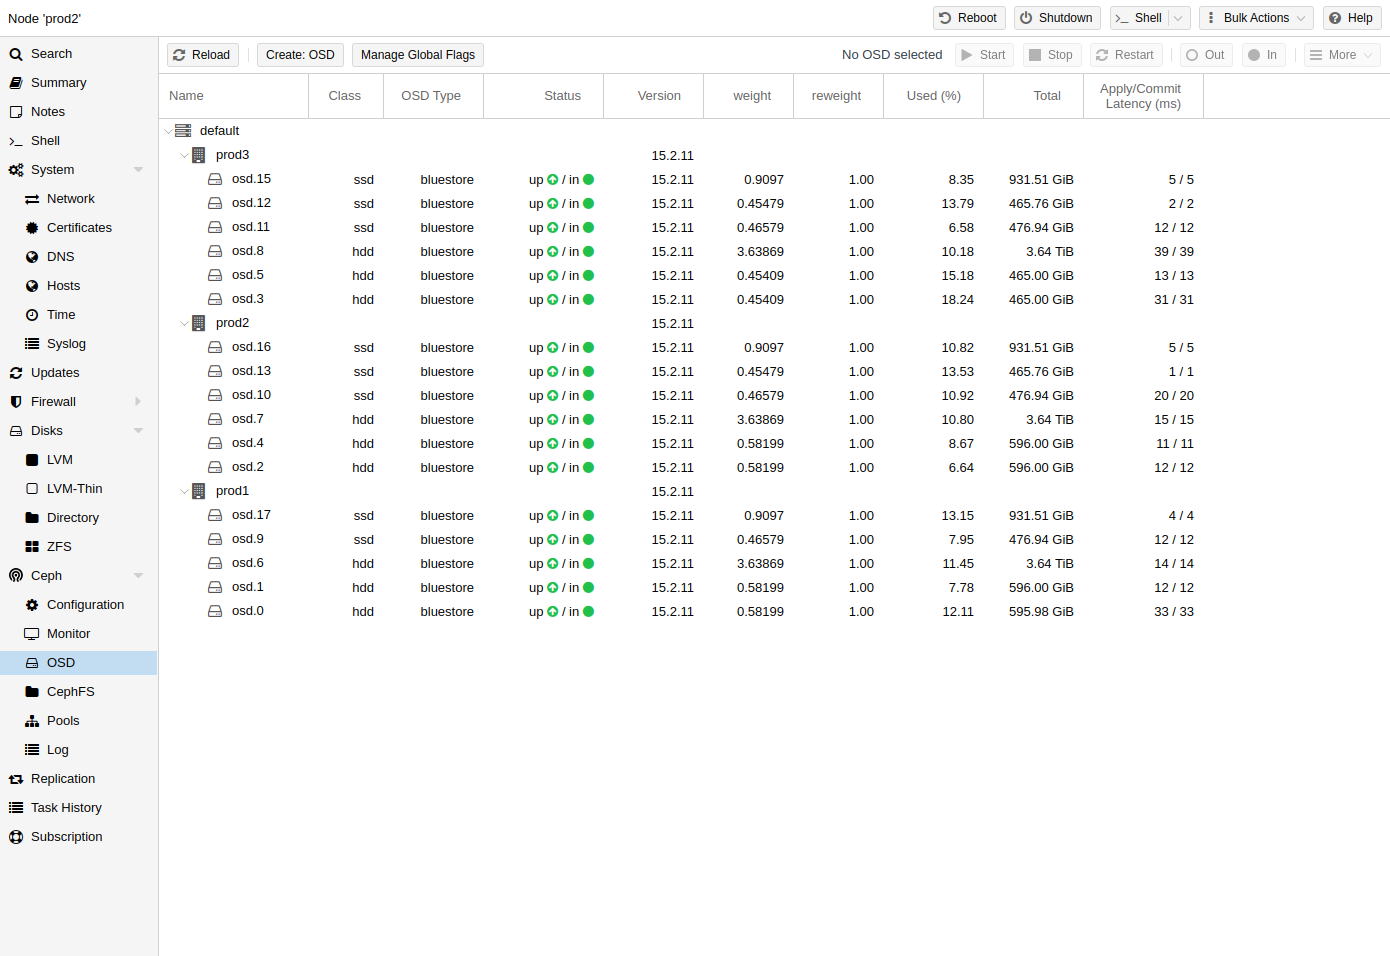
# proxmox-1
pveceph install --repository no-subscription
pveceph init --network 192.168.1.0/24 --cluster-network 10.10.10.0/24 --size 2 --min_size 1
pveceph mon create
pveceph mgr create        # « already exists » = déjà créé avec le moniteur, passe
pveceph osd create /dev/sdb
# proxmox-2
pveceph install --repository no-subscription
pveceph mon create
pveceph mgr create
pveceph osd create /dev/sdb
Corriger le pool interne .mgr
Ceph crée tout seul un petit pool .mgr. S'il a été créé avec 3 copies, il ne peut pas être complet avec 2 OSD et l'état reste en HEALTH_WARN (« undersized »). Vérifie et corrige :
ceph osd pool get .mgr size              # si « size: 3 » :
ceph osd pool set .mgr size 2
ceph osd pool set .mgr min_size 1
ceph -s                 # attendu : HEALTH_OK, 2 mons, 2 osds: 2 up, 2 in
ceph health detail
ceph mon stat
ceph mgr stat
ceph osd tree
ceph df
Si osd create refuse le disque (« already in use ») : ceph-volume lvm zap /dev/sdb --destroy sur le nœud concerné, puis recommence.
Partie 5Pool Ceph pour les VM
Par défaut un pool garde 3 copies (size 3). Avec 2 OSD, il faut size 2 / min_size 1.
Créer le pool Exemple tiré de la Documentation Proxmox VE · clique pour agrandir
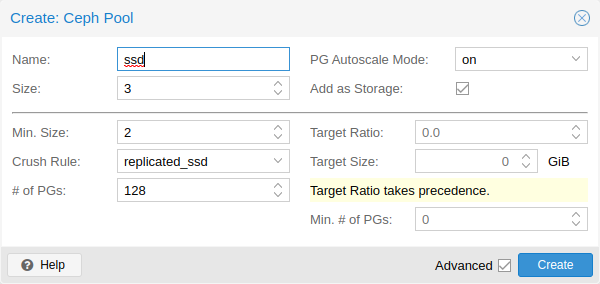
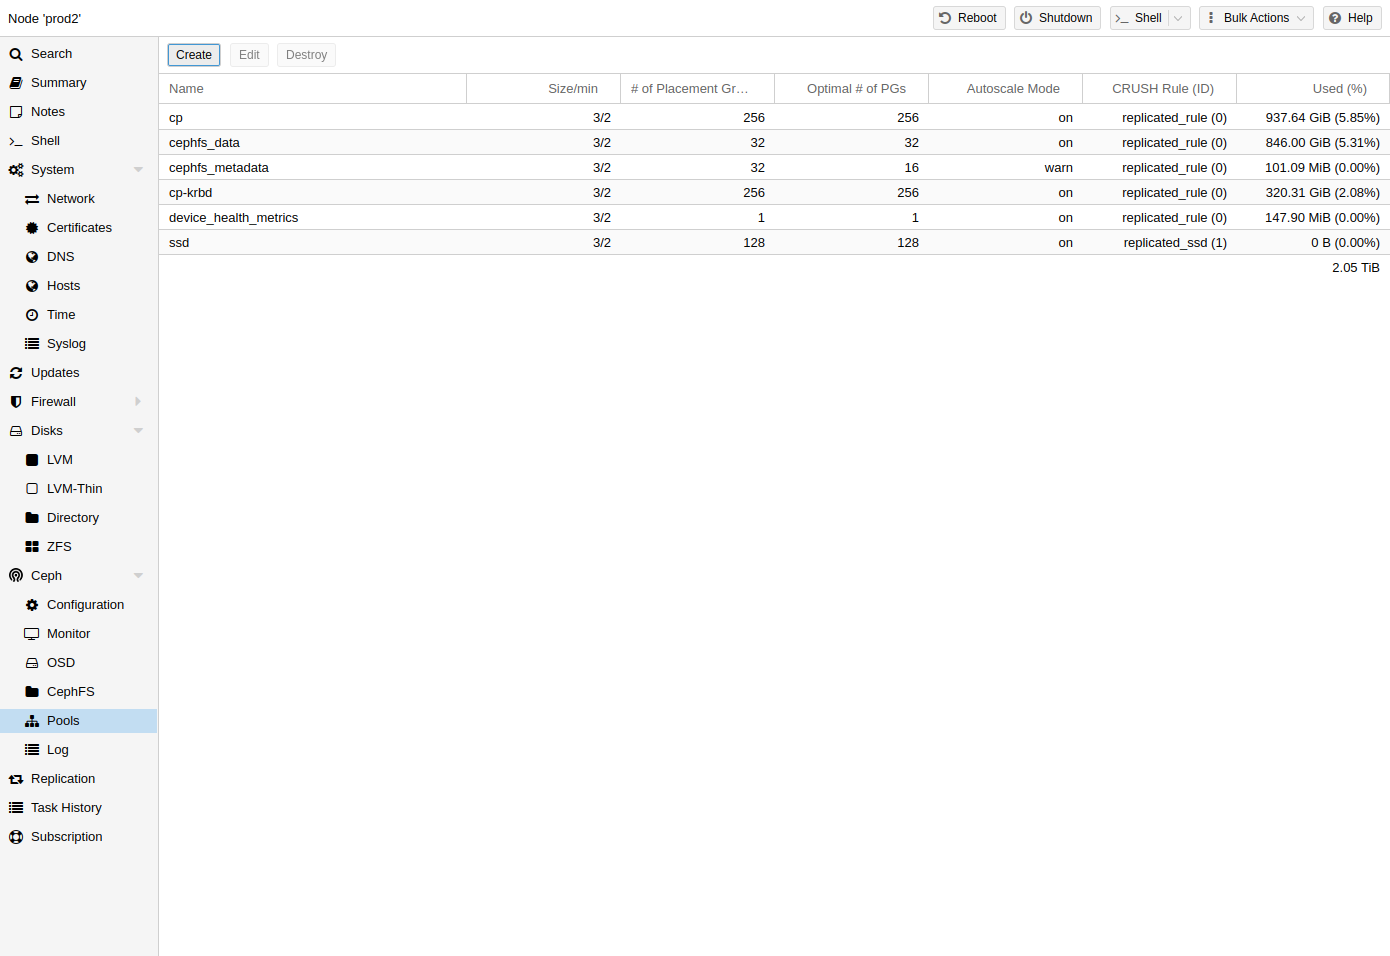
pveceph pool create vm-pool --size 2 --min_size 1 --add_storages
pvesm status
ceph osd pool ls detail
ceph osd pool get vm-pool size
min_size 1 permet d'écrire avec une seule copie disponible : pratique pour le TP, risqué en production (perte de données si le dernier disque lâche). À justifier dans le rendu.
Partie 6VM hébergée sur Ceph
On crée une petite VM Alpine Linux dont le disque est sur vm-pool.
Télécharger l'ISO Alpine sur proxmox-1
Ouvre https://dl-cdn.alpinelinux.org/alpine/latest-stable/releases/x86_64/ dans ton navigateur, copie le lien du fichier alpine-virt-3.xx.x-x86_64.iso (version « virt », la plus légère), colle-le dans URL › Query URL › Download.
Créer la VM
- Create VM
- sur
proxmox-1, VM ID100, nomvm-ceph - OS
- ISO
alpine-virt-…iso(stockagelocal), Type Linux - Disks
- Storage
vm-pool,8GiB - CPU / Memory
1cœur /1024MiB- Network
- Bridge
vmbr0, VirtIO
ISO_ALP=$(pvesm list local --content iso | awk '/alpine-virt/ {print $1; exit}')
echo $ISO_ALP
qm create 100 --name vm-ceph --ostype l26 --cores 1 --memory 1024 \
  --scsihw virtio-scsi-single --scsi0 vm-pool:8 \
  --net0 virtio,bridge=vmbr0 --ide2 $ISO_ALP,media=cdrom --boot order='ide2;scsi0'
qm start 100
Installer Alpine sur le disque Ceph
Console de la VM : login root (sans mot de passe), puis lance setup-alpine et réponds :
- Keyboard layout
frpuisfr- Hostname
vm-ceph- Interface
eth0- IP address
192.168.1.20/24(si un masque est demandé :255.255.255.0)- Gateway
192.168.1.1; configuration manuelle du réseau :n- DNS
- domaine : vide ; serveur :
192.168.1.1 - Root password
- un mot de passe (deux fois)
- Timezone / Proxy / NTP
Europe/Paris/none/ défaut- Mirror
1(premier de la liste) ouf(le plus rapide)- User / SSH
- pas d'utilisateur (
no) ; serveur SSHopenssh - Disk
sda, usagesys, effacer :y
À la fin, tape poweroff. Retire l'ISO (Hardware › CD/DVD Drive › Edit › Do not use any media), puis Start : la VM démarre depuis son disque sur Ceph.
ip -4 a
ping -c 3 192.168.1.1
Vérifier le stockage et la réplication
qm config 100 | grep scsi0      # scsi0: vm-pool:vm-100-disk-0
rbd ls vm-pool
rbd info vm-pool/vm-100-disk-0
ceph pg ls-by-pool vm-pool | head     # colonne ACTING : [0,1] = une copie sur chaque OSD
Partie 7Tests de résilience
Avant chaque scénario : la VM 100 tourne, ceph -s est en HEALTH_OK et pvecm status affiche Quorate: Yes. Pendant les tests, laisse un ping 192.168.1.20 tourner depuis un shell pour voir si la VM répond toujours.
Scénario 1 : arrêt d'un service Ceph
ceph osd tree               # repère le numéro de l'OSD de proxmox-2 (osd.1 en général)
systemctl stop ceph-osd@1
ceph -s                     # 1 osds down, PG degraded, la VM continue (min_size 1)
systemctl start ceph-osd@1
ceph -w                     # observe la récupération, Ctrl+C pour quitter
En graphique : proxmox-2 › Ceph › OSD › sélectionne l'OSD › Stop, puis Start.
Scénario 2 : coupure du réseau Ceph
ip link set ens19 down
sleep 60; ceph -s
ip link set ens19 up
sleep 30; ceph -s
Scénario 3 : arrêt complet d'un nœud
Sur le Proxmox de l'école : VM proxmox-2 › Stop (coupure brutale). Ou en CLI : qm stop 152. Puis sur proxmox-1 :
pvecm status           # Quorate: No : création, démarrage et migration bloqués
timeout 15 ceph -s     # ne répond pas : 1 MON sur 2 = plus de quorum Ceph, les E/S de la VM se figent
Remise en service : redémarre la VM proxmox-2 (Start, ou qm start 152), attends 1 à 2 minutes, puis vérifie pvecm status (Quorate: Yes) et ceph -s (retour à HEALTH_OK après récupération).
Dépannage si proxmox-2 ne peut pas revenir : sur proxmox-1, pvecm expected 1 rend le quorum Proxmox (à n'utiliser que temporairement, jamais si les deux nœuds tournent séparément).
Ce que tu dois observer et expliquer : avec 2 nœuds, la perte d'un nœud fait perdre la majorité, donc le quorum Proxmox et le quorum des moniteurs Ceph. La solution propre est un 3e vote : un QDevice (apt install corosync-qnetd sur une 3e machine, apt install corosync-qdevice sur les nœuds, puis pvecm qdevice setup IP) et un 3e MON Ceph.
Partie 8Analyse comparative
| Critère | Stockage local | NFS / SAN | Ceph distribué |
|---|---|---|---|
| Performances | Très élevées, pas de réseau | Moyennes, limitées par le lien | Variables, dépend du réseau et du nombre d'OSD |
| Résilience | Aucune | Point unique de défaillance | Réplication native, autoréparation |
| Complexité | Faible | Modérée | Élevée (quorum, réseau dédié, 3 nœuds conseillés) |
| Cas d'usage | Dev, test, lab | PME, NAS | Cloud, datacenter, HCI |